update readme
 gongjy
parent
f77b85b672
commit
37f39980ce
412
README.md
412
README.md
|
|
@ -16,7 +16,6 @@
|
||||||
<h3>"大道至简"</h3>
|
<h3>"大道至简"</h3>
|
||||||
</div>
|
</div>
|
||||||
|
|
||||||
|
|
||||||
* 本开源项目旨在完全从0开始,最快仅用3小时!即可训练出仅为26M大小的微型语言模型**MiniMind**。
|
* 本开源项目旨在完全从0开始,最快仅用3小时!即可训练出仅为26M大小的微型语言模型**MiniMind**。
|
||||||
* **MiniMind**极其轻量,体积约是 GPT3 的 $\frac{1}{7000}$,力求做到最普通的个人GPU也可快速推理甚至训练。
|
* **MiniMind**极其轻量,体积约是 GPT3 的 $\frac{1}{7000}$,力求做到最普通的个人GPU也可快速推理甚至训练。
|
||||||
* **MiniMind**改进自DeepSeek-V2、Llama3结构,项目包含整个数据处理、pretrain、sft、dpo的全部阶段,包含混合专家(MoE)模型。
|
* **MiniMind**改进自DeepSeek-V2、Llama3结构,项目包含整个数据处理、pretrain、sft、dpo的全部阶段,包含混合专家(MoE)模型。
|
||||||
|
|
@ -24,8 +23,13 @@
|
||||||
|
|
||||||
---
|
---
|
||||||
|
|
||||||
|
<div align="center">
|
||||||
|
|
||||||
|
https://github.com/user-attachments/assets/88b98128-636e-43bc-a419-b1b1403c2055
|
||||||
|
|
||||||
[Bilibili视频链接](https://www.bilibili.com/video/BV12dHPeqE72/?share_source=copy_web&vd_source=670c2504f88726f8cf4a21ef6147c0e8)
|
[Bilibili视频链接](https://www.bilibili.com/video/BV12dHPeqE72/?share_source=copy_web&vd_source=670c2504f88726f8cf4a21ef6147c0e8)
|
||||||
|
|
||||||
|
</div>
|
||||||
|
|
||||||
# 📌 Introduction
|
# 📌 Introduction
|
||||||
|
|
||||||
|
|
@ -39,15 +43,14 @@
|
||||||
因此,本项目的目标是把上手LLM的门槛无限降低,
|
因此,本项目的目标是把上手LLM的门槛无限降低,
|
||||||
直接从0开始训练一个极其轻量的语言模型。
|
直接从0开始训练一个极其轻量的语言模型。
|
||||||
|
|
||||||
(截至2024.09.01)MiniMind包含5个型号模型,最小仅需26M(0.02B),即可具备Amazing的对话能力!
|
> [!TIP]
|
||||||
|
> (截至2024-9-17)minimind训练了3个型号模型,最小仅需26M(0.02B),即可具备流畅的对话能力!
|
||||||
|
|
||||||
| 模型 (大小) | 速度 (Tokens/s) | 推理占用 | 训练占用(`batch_size=8`) | release | 主观评分(/100) |
|
| 模型 (大小) | tokenizer长度 | 推理占用 | release | 主观评分(/100) |
|
||||||
|------------------------|---------------|--------|----------------------|--------------------|------------|
|
|-------------------------|-------------|--------|------------|------------|
|
||||||
| MiniMind-small-T (26M) | 91.9 | 0.5 GB | 3.6 GB | 2024.08.28 | 55' |
|
| minimind-v1-small (26M) | 6400 | 0.5 GB | 2024.08.28 | 50' |
|
||||||
| MiniMind-small (56M) | 85.2 | 0.7 GB | 4.5 GB | 2024.08.28 | 55' |
|
| minimind-v1-moe (4×26M) | 6400 | 1.0 GB | 2024.09.17 | 55' |
|
||||||
| MiniMind (218M) | 57.6 | 2.1 GB | 10.4 GB | 2024.08.28 | 75' |
|
| minimind-v1 (108M) | 6400 | 1.0 GB | 2024.09.01 | 60' |
|
||||||
| MiniMind-MoE (166M) | 64.9 | 1.6 GB | 7.4 GB | 2024.08.28 | 40' |
|
|
||||||
| MiniMind-V1 (108M) | 78.3 | 1.0 GB | 6.4 GB | 2024.09.01 (new🎉) | 80' |
|
|
||||||
|
|
||||||
> 该分析在一个带有Torch 2.1.2、CUDA 12.2和Flash Attention 2的RTX 3090 GPU上运行。
|
> 该分析在一个带有Torch 2.1.2、CUDA 12.2和Flash Attention 2的RTX 3090 GPU上运行。
|
||||||
|
|
||||||
|
|
@ -63,12 +66,21 @@
|
||||||
|
|
||||||
希望此开源项目可以帮助LLM初学者快速入门!
|
希望此开源项目可以帮助LLM初学者快速入门!
|
||||||
|
|
||||||
👉**最近更新**
|
### 👉**最近更新**
|
||||||
|
|
||||||
<details close>
|
<details close>
|
||||||
<summary> <b>2024-09-01 (new🎉)</b> </summary>
|
<summary> <b>2024-09-17 (new🎉)</b> </summary>
|
||||||
|
|
||||||
- 更新MiniMind-V1 (108M)模型,采用minimind_tokenizer,预训练轮次3 + SFT轮次10,更充分训练,性能更强。
|
- 更新minimind-v1-moe模型
|
||||||
|
|
||||||
|
- 为了防止歧义,不再使用mistral_tokenizer分词,全部采用自定义的minimind_tokenizer作为分词器。
|
||||||
|
|
||||||
|
</details>
|
||||||
|
|
||||||
|
<details close>
|
||||||
|
<summary> <b>2024-09-01</b> </summary>
|
||||||
|
|
||||||
|
- 更新minimind-v1 (108M)模型,采用minimind_tokenizer,预训练轮次3 + SFT轮次10,更充分训练,性能更强。
|
||||||
|
|
||||||
- 项目已部署至ModelScope创空间,可以在此网站上体验:
|
- 项目已部署至ModelScope创空间,可以在此网站上体验:
|
||||||
|
|
||||||
|
|
@ -93,17 +105,19 @@
|
||||||
* CUDA == 12.2
|
* CUDA == 12.2
|
||||||
* [requirements.txt](./requirements.txt)
|
* [requirements.txt](./requirements.txt)
|
||||||
|
|
||||||
# 📌 Deployment & Inference
|
# 📌 Quick Inference & Test
|
||||||
|
|
||||||
<img src="https://huggingface.co/front/assets/huggingface_logo-noborder.svg" alt="Hugging Face Logo" style="vertical-align: middle; height: 30px;" />
|
<div align="center" style="font-size: 1.5em; font-weight: bold;">
|
||||||
|
<img src="https://huggingface.co/front/assets/huggingface_logo-noborder.svg" alt="Hugging Face Logo" style="vertical-align: middle; height: 30px;" />
|
||||||
Hugging Face
|
Hugging Face
|
||||||
|
|
||||||
[MiniMind (HuggingFace)](https://huggingface.co/collections/jingyaogong/minimind-66caf8d999f5c7fa64f399e5)
|
[MiniMind (HuggingFace)](https://huggingface.co/collections/jingyaogong/minimind-66caf8d999f5c7fa64f399e5)
|
||||||
|
|
||||||
<img src="https://g.alicdn.com/sail-web/maas/1.15.0/static/modelscopeIcon.cd89353f.svg" alt="Hugging Face Logo" style="vertical-align: middle; height: 30px;" />
|
<img src="https://g.alicdn.com/sail-web/maas/1.15.0/static/modelscopeIcon.cd89353f.svg" alt="Hugging Face Logo" style="vertical-align: middle; height: 30px;" />
|
||||||
|
|
||||||
[MiniMind (ModelScope)](https://www.modelscope.cn/models/gongjy/MiniMind-V1)
|
[MiniMind (ModelScope)](https://www.modelscope.cn/models/gongjy/minimind-v1)
|
||||||
|
|
||||||
|
</div>
|
||||||
|
|
||||||
```bash
|
```bash
|
||||||
# step 1
|
# step 1
|
||||||
|
|
@ -124,14 +138,21 @@ streamlit run fast_inference.py
|
||||||
|
|
||||||

|

|
||||||
|
|
||||||
|
<div align="center">
|
||||||
|
|
||||||
项目已部署至ModelScope创空间,可以在此网站上体验:
|
项目已部署至ModelScope创空间,可以在此网站上体验:
|
||||||
|
|
||||||
[ModelScope在线体验](https://www.modelscope.cn/studios/gongjy/minimind)
|
[ModelScope在线体验](https://www.modelscope.cn/studios/gongjy/minimind)
|
||||||
|
|
||||||
|
|
||||||
|
</div>
|
||||||
|
|
||||||
# 📌 Quick Start
|
# 📌 Quick Start
|
||||||
|
|
||||||
|
* 0、环境安装
|
||||||
|
```bash
|
||||||
|
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
|
||||||
|
```
|
||||||
* 1、克隆项目代码
|
* 1、克隆项目代码
|
||||||
```text
|
```text
|
||||||
git clone https://github.com/jingyaogong/minimind.git
|
git clone https://github.com/jingyaogong/minimind.git
|
||||||
|
|
@ -140,34 +161,29 @@ streamlit run fast_inference.py
|
||||||
|
|
||||||
* 2.1 下载[数据集下载地址](#数据集下载地址)放到`./dataset`目录下
|
* 2.1 下载[数据集下载地址](#数据集下载地址)放到`./dataset`目录下
|
||||||
|
|
||||||
* 2.2 `python data_process.py`处理数据集,例如pretrain数据提前进行token-encoder、sft数据集抽离qa到csv文件。
|
* 2.2 `python data_process.py`处理数据集,例如pretrain数据提前进行token-encoder、sft数据集抽离qa到csv文件
|
||||||
|
|
||||||
* 2.3 在`./model/LMConfig.py` 中调整model的参数配置。
|
* 2.3 在`./model/LMConfig.py` 中调整model的参数配置
|
||||||
* 2.4 `python 1-pretrain.py` 执行预训练。
|
* 2.4 `python 1-pretrain.py` 执行预训练
|
||||||
* 2.5 `python 3-full_sft.py` 执行指令微调。
|
* 2.5 `python 3-full_sft.py` 执行指令微调
|
||||||
* 2.6 `python 4-lora_sft.py` 执行lora微调(非必须)。
|
* 2.6 `python 4-lora_sft.py` 执行lora微调(非必须)
|
||||||
* 2.7 `python 5-dpo_train.py` 执行DPO人类偏好强化学习对齐(非必须)。
|
* 2.7 `python 5-dpo_train.py` 执行DPO人类偏好强化学习对齐(非必须)
|
||||||
* 3、测试模型推理效果
|
* 3、测试模型推理效果
|
||||||
* 从下面【训练完成的模型权重】下载权重到`./out/`目录下
|
* 确保需要使用的,训练完成的参数权重位于`./out/`目录下
|
||||||
|
* 也可以直接去[训练完成的模型权重](#训练完成的模型权重)下载使用我训练好的
|
||||||
```text
|
```text
|
||||||
out
|
out
|
||||||
├── multi_chat
|
├── multi_chat
|
||||||
│ ├── full_sft_1024.pth
|
|
||||||
│ ├── full_sft_512.pth
|
│ ├── full_sft_512.pth
|
||||||
│ ├── full_sft_640_moe.pth
|
│ ├── full_sft_512_moe.pth
|
||||||
│ └── full_sft_640.pth
|
│ └── full_sft_768.pth
|
||||||
├── single_chat
|
├── single_chat
|
||||||
│ ├── full_sft_1024.pth
|
|
||||||
│ ├── full_sft_512.pth
|
│ ├── full_sft_512.pth
|
||||||
│ ├── full_sft_640_moe.pth
|
│ ├── full_sft_512_moe.pth
|
||||||
│ └── full_sft_640.pth
|
│ └── full_sft_768.pth
|
||||||
├── full_sft_1024.pth
|
├── pretrain_768.pth
|
||||||
├── full_sft_512.pth
|
├── pretrain_512_moe.pth
|
||||||
├── full_sft_640_moe.pth
|
├── pretrain_512.pth
|
||||||
├── full_sft_640.pth
|
|
||||||
├── pretrain_1024.pth
|
|
||||||
├── pretrain_640_moe.pth
|
|
||||||
├── pretrain_640.pth
|
|
||||||
```
|
```
|
||||||
* `python 0-eval_pretrain.py`测试预训练模型的接龙效果
|
* `python 0-eval_pretrain.py`测试预训练模型的接龙效果
|
||||||
* `python 2-eval.py`测试模型的对话效果
|
* `python 2-eval.py`测试模型的对话效果
|
||||||
|
|
@ -198,28 +214,36 @@ streamlit run fast_inference.py
|
||||||
因为LLM体积非常小,为了避免模型头重脚轻(词嵌入embedding层参数占整个LLM比太高),所以词表长度需要选择比较小。
|
因为LLM体积非常小,为了避免模型头重脚轻(词嵌入embedding层参数占整个LLM比太高),所以词表长度需要选择比较小。
|
||||||
强大的开源模型例如01万物、千问、chatglm、mistral、Llama3等,它们的tokenizer词表长度如下:
|
强大的开源模型例如01万物、千问、chatglm、mistral、Llama3等,它们的tokenizer词表长度如下:
|
||||||
|
|
||||||
| Tokenizer 模型 | 词表大小 | 来源 |
|
<table>
|
||||||
|--------------------|---------|----------------|
|
<tr><th>Tokenizer模型</th><th>词表大小</th><th>来源</th></tr>
|
||||||
| yi tokenizer | 64,000 | 01万物(中国) |
|
<tr><td>yi tokenizer</td><td>64,000</td><td>01万物(中国)</td></tr>
|
||||||
| qwen2 tokenizer | 151,643 | 阿里云(中国) |
|
<tr><td>qwen2 tokenizer</td><td>151,643</td><td>阿里云(中国)</td></tr>
|
||||||
| glm tokenizer | 151,329 | 智谱AI(中国) |
|
<tr><td>glm tokenizer</td><td>151,329</td><td>智谱AI(中国)</td></tr>
|
||||||
| mistral tokenizer | 32,000 | Mistral AI(法国) |
|
<tr><td>mistral tokenizer</td><td>32,000</td><td>Mistral AI(法国)</td></tr>
|
||||||
| llama3 tokenizer | 128,000 | Meta(美国) |
|
<tr><td>llama3 tokenizer</td><td>128,000</td><td>Meta(美国)</td></tr>
|
||||||
| minimind tokenizer | 6,400 | 自定义 |
|
<tr><td>minimind tokenizer</td><td>6,400</td><td>自定义</td></tr>
|
||||||
|
</table>
|
||||||
|
|
||||||
> 尽管Mistral中文词语占比很少,编解码效率弱于qwen2、glm等中文友好型分词器。
|
> [!TIP]
|
||||||
> 但MiniMind这里选择了mistral tokenizer作为分词器以保持整体参数轻量,避免头重脚轻,因为mistral的词表大小只有32,000。
|
> 2024-09-17更新:为了防止过去的版本歧义&控制体积,minimind所有模型均使用minimind_tokenizer分词,废弃所有mistral_tokenizer版本。
|
||||||
> 且MiniMind在实际测试中几乎没有出现过生僻词汇解码失败的情况,效果良好。
|
|
||||||
|
|
||||||
> 方便对比测试效果,额外训练了一个自定义Tokenizer模型的版本**MiniMind-small-T**,自定义词表压缩长度到6400,使得LLM总参数进一步降低到26M左右。
|
> 尽管minimind_tokenizer长度很小,编解码效率弱于qwen2、glm等中文友好型分词器。
|
||||||
|
> 但minimind模型选择了自己训练的minimind_tokenizer作为分词器,以保持整体参数轻量,避免编码层和计算层占比失衡,头重脚轻,因为minimind的词表大小只有6400。
|
||||||
|
> 且minimind在实际测试中没有出现过生僻词汇解码失败的情况,效果良好。
|
||||||
|
> 由于自定义词表压缩长度到6400,使得LLM总参数量最低只有26M。
|
||||||
|
|
||||||
---
|
---
|
||||||
|
|
||||||
- 📙【Pretrain数据】:
|
- 📙【Pretrain数据】:
|
||||||
[seq-monkey通用文本数据集](https://github.com/mobvoi/seq-monkey-data/blob/main/docs/pretrain_open_corpus.md)
|
[Seq-Monkey通用文本数据集](https://github.com/mobvoi/seq-monkey-data/blob/main/docs/pretrain_open_corpus.md) / [Seq-Monkey百度网盘](https://pan.baidu.com/s/114F1k3eksiWCOQLvaT3RYQ?pwd=6666)
|
||||||
是由多种公开来源的数据(如网页、百科、博客、开源代码、书籍等)汇总清洗而成。整理成统一的JSONL格式,并经过了严格的筛选和去重,确保数据的全面性、规模、可信性和高质量。总量大约在10B
|
是由多种公开来源的数据(如网页、百科、博客、开源代码、书籍等)汇总清洗而成。整理成统一的JSONL格式,并经过了严格的筛选和去重,确保数据的全面性、规模、可信性和高质量。总量大约在10B
|
||||||
token,适合中文大语言模型的预训练。
|
token,适合中文大语言模型的预训练。
|
||||||
|
|
||||||
|
> 第2种选择:[SkyPile-150B数据集](https://hf-mirror.com/datasets/Skywork/SkyPile-150B/tree/main/data)
|
||||||
|
的可公开访问部分包含约2.33亿个独立网页,每个网页平均包含1000多个汉字。数据集包括大约1500亿个令牌和620GB的纯文本数据。
|
||||||
|
**如果着急的话**,可以尝试只挑选SkyPile-150B的部分jsonl下载(并在./data_process.py中对文本tokenizer生成*
|
||||||
|
.bin文件),以便快速跑通预训练流程。
|
||||||
|
|
||||||
---
|
---
|
||||||
|
|
||||||
- 📕【SFT数据】:[匠数大模型SFT数据集](https://www.modelscope.cn/datasets/deepctrl/deepctrl-sft-data)
|
- 📕【SFT数据】:[匠数大模型SFT数据集](https://www.modelscope.cn/datasets/deepctrl/deepctrl-sft-data)
|
||||||
|
|
@ -252,13 +276,15 @@ streamlit run fast_inference.py
|
||||||
|
|
||||||
### 数据集下载地址
|
### 数据集下载地址
|
||||||
|
|
||||||
|
下载到`./dataset/`目录下
|
||||||
|
|
||||||
| MiniMind训练数据集 | 下载地址 |
|
| MiniMind训练数据集 | 下载地址 |
|
||||||
|--------------------|----------------------------------------------------------------------------------------------------------------------------------------------------------|
|
|--------------------|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
|
||||||
| **【tokenizer训练集】** | [HuggingFace](https://huggingface.co/datasets/jingyaogong/minimind_dataset/tree/main) / [百度网盘](https://pan.baidu.com/s/1yAw1LVTftuhQGAC1Y9RdYQ?pwd=6666) |
|
| **【tokenizer训练集】** | [HuggingFace](https://huggingface.co/datasets/jingyaogong/minimind_dataset/tree/main) / [百度网盘](https://pan.baidu.com/s/1yAw1LVTftuhQGAC1Y9RdYQ?pwd=6666) |
|
||||||
| **【Pretrain数据】** | [seq-monkey通用文本数据集](http://share.mobvoi.com:5000/sharing/O91blwPkY) |
|
| **【Pretrain数据】** | [Seq-Monkey官方](http://share.mobvoi.com:5000/sharing/O91blwPkY) / [百度网盘](https://pan.baidu.com/s/1-Z8Q37lJD4tOKhyBs1D_6Q?pwd=6666) / [HuggingFace](https://huggingface.co/datasets/jingyaogong/minimind_dataset/tree/main) |
|
||||||
| **【SFT数据】** | [匠数大模型SFT数据集](https://www.modelscope.cn/datasets/deepctrl/deepctrl-sft-data/resolve/master/sft_data_zh.jsonl) |
|
| **【SFT数据】** | [匠数大模型SFT数据集](https://www.modelscope.cn/datasets/deepctrl/deepctrl-sft-data/resolve/master/sft_data_zh.jsonl) |
|
||||||
| **【DPO数据】** | [活字数据集1](https://huggingface.co/datasets/Skepsun/huozi_rlhf_data_json) |
|
| **【DPO数据1】** | [活字数据集1](https://huggingface.co/datasets/Skepsun/huozi_rlhf_data_json) |
|
||||||
| **【DPO数据】** | [活字数据集2](https://huggingface.co/datasets/beyond/rlhf-reward-single-round-trans_chinese) |
|
| **【DPO数据2】** | [活字数据集2](https://huggingface.co/datasets/beyond/rlhf-reward-single-round-trans_chinese) |
|
||||||
|
|
||||||
# 📌 Model
|
# 📌 Model
|
||||||
|
|
||||||
|
|
@ -282,18 +308,15 @@ MiniMind的整体结构一致,只是在RoPE计算、推理函数和FFN层的
|
||||||

|

|
||||||

|

|
||||||
|
|
||||||
模型配置见[./model/LMConfig.py](./model/LMConfig.py)。模型型号和参数见下表:
|
修改模型配置见[./model/LMConfig.py](./model/LMConfig.py)。
|
||||||
|
minimind目前训练的模型版本见下表:
|
||||||
|
|
||||||
| Model Name | params | len_vocab | n_layers | d_model | kv_heads | q_heads | share+route | TopK |
|
| Model Name | params | len_vocab | n_layers | d_model | kv_heads | q_heads | share+route | TopK |
|
||||||
|------------------|--------|-----------|----------|---------|----------|---------|-------------|------|
|
|------------------|--------|-----------|----------|---------|----------|---------|-------------|------|
|
||||||
| minimind-small-T | 26M | 6400 | 8 | 512 | 8 | 16 | - | - |
|
| minimind-v1-small | 26M | 6400 | 8 | 512 | 8 | 16 | - | - |
|
||||||
| minimind-small | 56M | 32000 | 8 | 640 | 8 | 16 | - | - |
|
| minimind-v1-moe | 4×26M | 6400 | 8 | 512 | 8 | 16 | 2+4 | 2 |
|
||||||
| minimind | 218M | 32000 | 16 | 1024 | 8 | 16 | - | - |
|
| minimind-v1 | 108M | 6400 | 16 | 768 | 8 | 16 | - | - |
|
||||||
| minimind-MoE | 162M | 32000 | 8 | 640 | 8 | 16 | 2+4 | 2 |
|
|
||||||
| minimind-V1 | 108M | 6400 | 16 | 768 | 8 | 16 | - | - |
|
|
||||||
|
|
||||||
此外作为参考,GPT3的层数和维度参数见下表:
|
|
||||||

|
|
||||||
|
|
||||||
# 📌 Experiment
|
# 📌 Experiment
|
||||||
|
|
||||||
|
|
@ -305,12 +328,10 @@ CPU: Intel(R) Core(TM) i9-10980XE CPU @ 3.00GHz
|
||||||
```
|
```
|
||||||
|
|
||||||
| Model Name | params | len_vocab | batch_size | pretrain_time | sft_single_time | sft_multi_time |
|
| Model Name | params | len_vocab | batch_size | pretrain_time | sft_single_time | sft_multi_time |
|
||||||
|------------------|--------|-----------|------------|--------------------|-------------------|---------------------|
|
|------------------|--------|-----------|------------|-------------------|-------------------|---------------------|
|
||||||
| minimind-small-T | 26M | 6400 | 64 | ≈5 hour (1 epoch) | ≈2 hour (1 epoch) | ≈0.5 hour (1 epoch) |
|
| minimind-v1-small | 26M | 6400 | 64 | ≈2 hour (1 epoch) | ≈2 hour (1 epoch) | ≈0.5 hour (1 epoch) |
|
||||||
| minimind-small | 56M | 32000 | 24 | ≈6 hour (1 epoch) | ≈2 hour (1 epoch) | ≈0.5 hour (1 epoch) |
|
| minimind-v1-moe | 4×26M | 6400 | 40 | ≈6 hour (1 epoch) | ≈5 hour (1 epoch) | ≈1 hour (1 epoch) |
|
||||||
| minimind | 218M | 32000 | 16 | ≈15 hour (1 epoch) | ≈5 hour (1 epoch) | ≈1 hour (1 epoch) |
|
| minimind-v1 | 108M | 6400 | 16 | ≈6 hour (1 epoch) | ≈4 hour (1 epoch) | ≈1 hour (1 epoch) |
|
||||||
| minimind-MoE | 166M | 32000 | 16 | ≈13 hour (1 epoch) | ≈5 hour (1 epoch) | ≈1 hour (1 epoch) |
|
|
||||||
| minimind-V1 | 108M | 6400 | 16 | ≈8 hour (1 epoch) | ≈3 hour (1 epoch) | ≈1 hour (1 epoch) |
|
|
||||||
|
|
||||||
---
|
---
|
||||||
|
|
||||||
|
|
@ -318,7 +339,7 @@ CPU: Intel(R) Core(TM) i9-10980XE CPU @ 3.00GHz
|
||||||
- LLM首先要学习的并非直接与人交流,而是让肚子中充满知识的墨水,至于墨水理论上喝的越饱越好,产生大量的对世界的认知积累。
|
- LLM首先要学习的并非直接与人交流,而是让肚子中充满知识的墨水,至于墨水理论上喝的越饱越好,产生大量的对世界的认知积累。
|
||||||
- 预训练就是让Model先埋头苦学大量基本的知识,例如从维基百科、新闻、常识、书籍等。
|
- 预训练就是让Model先埋头苦学大量基本的知识,例如从维基百科、新闻、常识、书籍等。
|
||||||
- 它无监督的从大量的文本数据中压缩知识到自己模型的权重,目的是:学会词语接龙。例如我们输入“秦始皇是”四个字,它在大量学习后能预测出下一句话大概率是“中国的第一位皇帝”。
|
- 它无监督的从大量的文本数据中压缩知识到自己模型的权重,目的是:学会词语接龙。例如我们输入“秦始皇是”四个字,它在大量学习后能预测出下一句话大概率是“中国的第一位皇帝”。
|
||||||
> pretrain的学习率设置为1e-4到1e-5的动态学习率,预训练epoch数设为2,预训练时间不到1天。
|
> pretrain的学习率设置为1e-4到1e-5的动态学习率,预训练epoch数设为5。
|
||||||
```bash
|
```bash
|
||||||
torchrun --nproc_per_node 2 1-pretrain.py
|
torchrun --nproc_per_node 2 1-pretrain.py
|
||||||
```
|
```
|
||||||
|
|
@ -328,7 +349,7 @@ CPU: Intel(R) Core(TM) i9-10980XE CPU @ 3.00GHz
|
||||||
”后不再无脑接龙,而是意识到这是一段完整的对话结束。
|
”后不再无脑接龙,而是意识到这是一段完整的对话结束。
|
||||||
- 我们称这个过程为指令微调,就如同让学富五车的「牛顿」先生适应21世纪的聊天习惯,学习屏幕左侧是对方消息,右侧是本人消息这个规律。
|
- 我们称这个过程为指令微调,就如同让学富五车的「牛顿」先生适应21世纪的聊天习惯,学习屏幕左侧是对方消息,右侧是本人消息这个规律。
|
||||||
- 在训练时,MiniMind的指令和回答长度被截断在512,是为了节省显存空间。就像我们学习时,会先从短的文章开始,当学会阅读200字作文后,800字长文章就不需要再单独学习。
|
- 在训练时,MiniMind的指令和回答长度被截断在512,是为了节省显存空间。就像我们学习时,会先从短的文章开始,当学会阅读200字作文后,800字长文章就不需要再单独学习。
|
||||||
> 在推理时通过调整RoPE线性差值,实现长度外推到1024或2048及以上很方便。学习率设置为1e-5到1e-6的动态学习率,微调epoch数为5。
|
> 在推理时通过调整RoPE线性差值,实现长度外推到1024或2048及以上很方便。学习率设置为1e-5到1e-6的动态学习率,微调epoch数为6。
|
||||||
|
|
||||||
```bash
|
```bash
|
||||||
# 3-full_sft.py中设置数据集为sft_data_single.csv
|
# 3-full_sft.py中设置数据集为sft_data_single.csv
|
||||||
|
|
@ -340,7 +361,7 @@ CPU: Intel(R) Core(TM) i9-10980XE CPU @ 3.00GHz
|
||||||
- 构建【问题->回答,问题->回答,问题->】的新聊天模板,然后使用这个数据集进行微调。
|
- 构建【问题->回答,问题->回答,问题->】的新聊天模板,然后使用这个数据集进行微调。
|
||||||
- 学习完成的模型不仅仅只能回答当前问题,还能根据历史对话进行连贯的对话。
|
- 学习完成的模型不仅仅只能回答当前问题,还能根据历史对话进行连贯的对话。
|
||||||
- 这一步并非必须,因为小模型长上文对话能力很弱,强行对齐多轮问答模板会损失一定程度的单轮SFT效果。
|
- 这一步并非必须,因为小模型长上文对话能力很弱,强行对齐多轮问答模板会损失一定程度的单轮SFT效果。
|
||||||
> 学习率设置为1e-5到1e-6的动态学习率,微调epoch数为2。
|
> 学习率设置为1e-5到1e-6的动态学习率,微调epoch数为5。
|
||||||
```bash
|
```bash
|
||||||
# 3-full_sft.py中设置数据集为sft_data.csv
|
# 3-full_sft.py中设置数据集为sft_data.csv
|
||||||
torchrun --nproc_per_node 2 3-full_sft.py
|
torchrun --nproc_per_node 2 3-full_sft.py
|
||||||
|
|
@ -352,21 +373,9 @@ CPU: Intel(R) Core(TM) i9-10980XE CPU @ 3.00GHz
|
||||||
```bash
|
```bash
|
||||||
python 5-dpo_train.py
|
python 5-dpo_train.py
|
||||||
```
|
```
|
||||||
|
|
||||||
---
|
|
||||||
🔗训练完成的模型权重:
|
|
||||||
|
|
||||||
| Model Name | params | Config | pretrain_model | single_sft_model | multi_sft_model |
|
|
||||||
|------------------|--------|-------------------------------------------------|----------------------------------------------------------------|----------------------------------------------------------------|----------------------------------------------------------------|
|
|
||||||
| minimind-small-T | 26M | d_model=512<br/>n_layers=8 | - | [链接](https://pan.baidu.com/s/1_COe0FQRDmeapSsvArahCA?pwd=6666) | [链接](https://pan.baidu.com/s/1GsGsWSL0Dckl0YPRXiBIFQ?pwd=6666) |
|
|
||||||
| minimind-small | 56M | d_model=640<br/>n_layers=8 | [链接](https://pan.baidu.com/s/1nJuOpnu5115FDuz6Ewbeqg?pwd=6666) | [链接](https://pan.baidu.com/s/1lRX0IcpjNFSySioeCfifRQ?pwd=6666) | [链接](https://pan.baidu.com/s/1LzVxBpL0phtGUH267Undqw?pwd=6666) |
|
|
||||||
| minimind | 218M | d_model=1024<br/>n_layers=16 | [链接](https://pan.baidu.com/s/1jzA7uLEi-Jen2fW5olCmEg?pwd=6666) | [链接](https://pan.baidu.com/s/1Hvt0Q_UB_uW2sWTw6w1zRQ?pwd=6666) | [链接](https://pan.baidu.com/s/1fau9eat3lXilnrG3XNhG5Q?pwd=6666) |
|
|
||||||
| minimind-MoE | 166M | d_model=1024<br/>n_layers=8<br/>share+route=2+4 | [链接](https://pan.baidu.com/s/11CneDVTkw2Y6lNilQX5bWw?pwd=6666) | [链接](https://pan.baidu.com/s/1fRq4MHZec3z-oLK6sCzj_A?pwd=6666) | [链接](https://pan.baidu.com/s/1HC2KSM_-RHRtgv7ZDkKI9Q?pwd=6666) |
|
|
||||||
| minimind-V1 | 108M | d_model=768<br/>n_layers=16 | - | [链接](https://pan.baidu.com/s/1p713loS7EfwHQf3G9eYI3Q?pwd=6666) | [链接](https://pan.baidu.com/s/12iHGpAs6R0kqsOnGtgK6vQ?pwd=6666) |
|
|
||||||
|
|
||||||
---
|
---
|
||||||
|
|
||||||
关于LLM的参数配置,有一篇很有意思的论文[MobileLLM](https://arxiv.org/pdf/2402.14905)做了详细的研究和实验。
|
📋关于LLM的参数配置,有一篇很有意思的论文[MobileLLM](https://arxiv.org/pdf/2402.14905)做了详细的研究和实验。
|
||||||
scaling law在小模型中有自己独特的规律。
|
scaling law在小模型中有自己独特的规律。
|
||||||
引起Transformer参数成规模变化的参数几乎只取决于`d_model`和`n_layers`。
|
引起Transformer参数成规模变化的参数几乎只取决于`d_model`和`n_layers`。
|
||||||
|
|
||||||
|
|
@ -379,95 +388,96 @@ MobileLLM提出架构的深度比宽度更重要,「深而窄」的「瘦长
|
||||||
例如当模型参数固定在125M或者350M时,30~42层的「狭长」模型明显比12层左右的「矮胖」模型有更优越的性能,
|
例如当模型参数固定在125M或者350M时,30~42层的「狭长」模型明显比12层左右的「矮胖」模型有更优越的性能,
|
||||||
在常识推理、问答、阅读理解等8个基准测试上都有类似的趋势。
|
在常识推理、问答、阅读理解等8个基准测试上都有类似的趋势。
|
||||||
这其实是非常有趣的发现,因为以往为100M左右量级的小模型设计架构时,几乎没人尝试过叠加超过12层。
|
这其实是非常有趣的发现,因为以往为100M左右量级的小模型设计架构时,几乎没人尝试过叠加超过12层。
|
||||||
|
|
||||||
这与MiniMind在训练过程中,模型参数量在`d_model`和`n_layers`之间进行调整实验观察到的效果是一致的。
|
这与MiniMind在训练过程中,模型参数量在`d_model`和`n_layers`之间进行调整实验观察到的效果是一致的。
|
||||||
然而「深而窄」的「窄」也是有维度极限的,当d_model<512时,词嵌入维度坍塌的劣势非常明显,
|
然而「深而窄」的「窄」也是有维度极限的,当d_model<512时,词嵌入维度坍塌的劣势非常明显,
|
||||||
增加的layers并不能弥补词嵌入在固定q_head带来d_head不足的劣势。
|
增加的layers并不能弥补词嵌入在固定q_head带来d_head不足的劣势。
|
||||||
当d_model>1536时,layers的增加似乎比d_model的优先级更高,更能带来具有“性价比”的参数->效果增益。
|
当d_model>1536时,layers的增加似乎比d_model的优先级更高,更能带来具有“性价比”的参数->效果增益。
|
||||||
因此MiniMind设定small模型的d_model=640,n_layers=8来获取的「极小体积<->更好效果」的平衡。
|
因此MiniMind设定small模型的d_model=512,n_layers=8来获取的「极小体积<->更好效果」的平衡。
|
||||||
设定d_model=1024,n_layers=16来获取效果的更大收益,更加符合小模型scaling-law的变化曲线。
|
设定d_model=768,n_layers=16来获取效果的更大收益,更加符合小模型scaling-law的变化曲线。
|
||||||
|
|
||||||
|
|
||||||
|
> 作为参考,GPT3的参数设定见下表:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
---
|
||||||
|
### 训练完成的模型权重
|
||||||
|
|
||||||
|
| Model Name | params | Config | pretrain_model | single_sft_model | multi_sft_model |
|
||||||
|
|-------------------|--------|-----------------------------|----------------|----------------------------------------------------------------|----------------------------------------------------------------|
|
||||||
|
| minimind-v1-small | 26M | d_model=512<br/>n_layers=8 | - | [链接](https://pan.baidu.com/s/1_COe0FQRDmeapSsvArahCA?pwd=6666) | [链接](https://pan.baidu.com/s/1GsGsWSL0Dckl0YPRXiBIFQ?pwd=6666) |
|
||||||
|
| minimind-v1-moe | 4×26M | d_model=512<br/>n_layers=8 | - | - | - |
|
||||||
|
| minimind-v1 | 108M | d_model=768<br/>n_layers=16 | - | [链接](https://pan.baidu.com/s/1p713loS7EfwHQf3G9eYI3Q?pwd=6666) | [链接](https://pan.baidu.com/s/12iHGpAs6R0kqsOnGtgK6vQ?pwd=6666) |
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
# 📌 Eval
|
# 📌 Eval
|
||||||
|
|
||||||
> 【注】以下测试于2024.8.28完成,此日期后发布的(例如MiniMind-V1)新模型,无特殊需要时将不加入测试。
|
> [!TIP]
|
||||||
|
> 以下测试于2024-09-17完成,此日期后发布的新模型,无特殊需要时将不加入测试。
|
||||||
[A] [minimind-small-T(0.02B)](https://pan.baidu.com/s/1_COe0FQRDmeapSsvArahCA?pwd=6666)<br/>
|
|
||||||
[B] [minimind-small(0.05B)](https://pan.baidu.com/s/1lRX0IcpjNFSySioeCfifRQ?pwd=6666)<br/>
|
|
||||||
[C] [minimind-MoE(0.16B)](https://pan.baidu.com/s/1fRq4MHZec3z-oLK6sCzj_A?pwd=6666)<br/>
|
|
||||||
[D] [minimind(0.2B)](https://pan.baidu.com/s/1Hvt0Q_UB_uW2sWTw6w1zRQ?pwd=6666)<br/>
|
|
||||||
[E] [baby-llama2-chinese(0.2B)](https://github.com/DLLXW/baby-llama2-chinese)<br/>
|
|
||||||
[F] [chatlm-mini-chinese(0.2B)](https://github.com/charent/ChatLM-mini-Chinese)<br/>
|
|
||||||
|
|
||||||
```angular2html
|
|
||||||
[Q]: 一星期有多少天?
|
|
||||||
[A]: 一星期有七天。
|
|
||||||
[B]: 一星期有7天。
|
|
||||||
[C]: 根据您的计算,一星期有12个小时。因此,我们需要将小时数乘以12。这样,我们就可以得到12的小时数。
|
|
||||||
[D]: 一星期共有七天。
|
|
||||||
[E]: 作为一个人工智能助手,我无法确定您所描述的星期数。 如果您能够提供您所描述的星期数,我可以为您提供有关该星期天数的信息。
|
|
||||||
[F]: 一星期有七天,也就是七天的积,也就是 7 x 7 = 24 天。这个数字是通过将 24 除以 7 得到的,因为一周有七天,所以一星期有 24 x 7 = 24 天。
|
|
||||||
|
|
||||||
|
[A] [minimind-v1-small(0.02B)](https://pan.baidu.com/s/1_COe0FQRDmeapSsvArahCA?pwd=6666)<br/>
|
||||||
|
[B] minimind-v1-moe(0.1B)<br/>
|
||||||
|
[C] [minimind-v1(0.1B)](https://pan.baidu.com/s/1p713loS7EfwHQf3G9eYI3Q?pwd=6666)<br/>
|
||||||
|
[D] [baby-llama2-chinese(0.2B)](https://github.com/DLLXW/baby-llama2-chinese)<br/>
|
||||||
|
[E] [chatlm-mini-chinese(0.2B)](https://github.com/charent/ChatLM-mini-Chinese)<br/>
|
||||||
|
|
||||||
|
```text
|
||||||
[Q]: 你知道长江吗?
|
[Q]: 你知道长江吗?
|
||||||
[A]: 是的,长江是中国最长的河流,全长超过3300千米。
|
[A]: 是的,长江是中国最长的河流,全长超过3300千米。
|
||||||
[B]: 是的,长江是中国最长的河流,全长约7100公里。它的流域面积约为3328万平方公里,是中国最大的河流之一,也是世界第三大河流,总长度约为6300千米。
|
[B]: 是的,长江是中国最长的河流,全长约7100公里。它的流域面积约为3328万平方公里,是中国最大的河流之一,也是世界第三大河流,总长度约为6300千米。
|
||||||
[C]: 我知道。长江是我国的一个重要水系,有着悠久的历史和文化。长江是中华民族的象征和精神支柱,也是世界上最美丽的自然景观之一。长江沿岸地区的人们,特别是在长江流域生活了数千年。长江在中国的历史和文化中,尤其是历史悠久的文化,有着深厚的历史和文化底蕴。
|
[C]: 是的,长江是中国最长的河流之一,也是世界第三大河流。长江发源于青藏高原,流经11个省份,最终注入东海。长江流域是中国最大的河流流域之一,拥有着丰富的自然资源和文化遗产,如长江大桥、长江海洋博物馆、长江古城等。
|
||||||
[D]: 长江是中国的第一大河流,全长约6380公里。它是亚洲最长的河流,也是中国第一大河流。长江流域是中国的重要河流之一,有着丰富的自然资源和文化遗产。长江流域是中国最重要的农业和经济发展区,拥有众多的文化遗产和历史景点,是中国最重要的文化旅游目的地之一。
|
[D]: 同时也知道,中国是世界上最长的城市之一,拥有超过3400万人口。
|
||||||
[E]: 同时也知道,中国是世界上最长的城市之一,拥有超过3400万人口。
|
[E]: 是的,长江是中国最长的河流,也是世界上最长的河流之一。它发源于青藏高原,流经九个省区,最终注入东海。长江流域的气候温和,四季分明,是中国重要的农业和工业基地。长江流域的水产资源丰富,是中国的重要渔业资源之一。
|
||||||
[F]: 是的,长江是中国最长的河流,也是世界上最长的河流之一。它发源于青藏高原,流经九个省区,最终注入东海。长江流域的气候温和,四季分明,是中国重要的农业和工业基地。长江流域的水产资源丰富,是中国的重要渔业资源之一。
|
|
||||||
|
|
||||||
|
|
||||||
[Q]: 第一颗人造卫星是哪个国家发射的?
|
[Q]: 第一颗人造卫星是哪个国家发射的?
|
||||||
[A]: 第一颗人造卫星是斯普特尼克1号。
|
[A]: 第一颗人造卫星是斯普特尼克1号。
|
||||||
[B]: 第一颗人造卫星是美国发射的。
|
[B]: 第一颗人造卫星是美国发射的。
|
||||||
[C]: 第一颗人造卫星是中国国家航天科技集团有限公司的卫星,它是中国航天科技集团公司的卫星,由中国航天科技集团公司发射。
|
[C]: 第一颗人造卫星是苏联发射的,它是由苏联于1957年10月发射的。
|
||||||
[D]: 第一颗人造卫星是苏联于1957年发射的。
|
[D]: 这颗名为“阿姆斯特朗”的卫星,于1961年11月20日发射,是第一个成功将人类送入太空的卫星。
|
||||||
[E]: 这颗名为“阿姆斯特朗”的卫星,于1961年11月20日发射,是第一个成功将人类送入太空的卫星。
|
[E]: 第一颗人造卫星是苏联于1957年4月4日发射的,它是由苏联宇航员尤里·加加林(Yuri Gagarin)和苏联工程师罗尔德·谢尔盖耶夫(Roald Skohley)共同发射的。在发射过程中,加加林和谢尔盖耶夫使用了一个名为“斯普特尼克1号”的小型卫星,它的直径为4.3米,重量为1,051公斤。这枚卫星被称为“斯普特尼克1号”,是苏联太空竞赛中的一个里程碑,也是人类历史上第一次在太空中进行太空行走。
|
||||||
[F]: 第一颗人造卫星是苏联于1957年4月4日发射的,它是由苏联宇航员尤里·加加林(Yuri Gagarin)和苏联工程师罗尔德·谢尔盖耶夫(Roald Skohley)共同发射的。在发射过程中,加加林和谢尔盖耶夫使用了一个名为“斯普特尼克1号”的小型卫星,它的直径为4.3米,重量为1,051公斤。这枚卫星被称为“斯普特尼克1号”,是苏联太空竞赛中的一个里程碑,也是人类历史上第一次在太空中进行太空行走。
|
|
||||||
|
|
||||||
|
|
||||||
[Q]: 你知道泰山在哪里吗?
|
[Q]: 你知道泰山在哪里吗?
|
||||||
[A]: 泰山位于中国东部地区,是中国五岳之一。
|
[A]: 泰山位于中国东部地区,是中国五岳之一。
|
||||||
[B]: 泰山位于山东省泰安市,是中国五岳之一。
|
[B]: 泰山位于山东省泰安市,是中国五岳之一。
|
||||||
[C]: 泰山在哪里呢?
|
[C]: 泰山位于中国山东省泰安市,是中国五岳之一。
|
||||||
[D]: 泰山位于中国山东省昆山市,是中国古代文化的瑰宝之一,也是世界著名的山岳风景区之一。泰山是五岳之一,以其险峻的山峰、秀丽的自然风光和丰富的文化底蕴而闻名于世。
|
[D]: 作为一个人工智能助手,我无法访问互联网,因此无法提供关于你所在位置的信息。不过,你可以通过搜索或搜索相关关键词来获取有关你所在位置的信息,或者查看相关新闻或网站来获取有关你所在位置的信息。
|
||||||
[E]: 作为一个人工智能助手,我无法访问互联网,因此无法提供关于你所在位置的信息。不过,你可以通过搜索或搜索相关关键词来获取有关你所在位置的信息,或者查看相关新闻或网站来获取有关你所在位置的信息。
|
[E]: 泰山位于中国山东省泰安市境内,是中国五岳之一,也是中国文化和历史的重要象征之一。它是中国五岳之一,也是中国道教和佛教的发源地之一。泰山的海拔高度为1,545米,是中国五岳之一,也是中国最著名的旅游景点之一。它的历史可以追溯到公元前5世纪,是中国古代帝王祭祀的场所。泰山也是中国文化的重要组成部分,被誉为“五岳之首”,是中国文化的重要遗产之一。
|
||||||
[F]: 泰山位于中国山东省泰安市境内,是中国五岳之一,也是中国文化和历史的重要象征之一。它是中国五岳之一,也是中国道教和佛教的发源地之一。泰山的海拔高度为1,545米,是中国五岳之一,也是中国最著名的旅游景点之一。它的历史可以追溯到公元前5世纪,是中国古代帝王祭祀的场所。泰山也是中国文化的重要组成部分,被誉为“五岳之首”,是中国文化的重要遗产之一。
|
|
||||||
|
|
||||||
|
|
||||||
[Q]: 世界上最高的山峰是什么?
|
[Q]: 世界上最高的山峰是什么?
|
||||||
[A]: 世界上最高的山峰是珠穆朗玛峰,位于尼泊尔和中国的边境上,海拔8848米。
|
[A]: 世界上最高的山峰是珠穆朗玛峰,位于尼泊尔和中国的边境上,海拔8848米。
|
||||||
[B]: 珠穆朗玛峰是世界上最高的山峰,位于喜马拉雅山脉,海拔8848米。
|
[B]: 珠穆朗玛峰是世界上最高的山峰,位于喜马拉雅山脉,海拔8848米。
|
||||||
[C]: 世界上最高的山峰是珠穆朗玛峰。
|
[C]: 珠穆朗玛峰是世界上最高的山峰,海拔8848米。
|
||||||
[D]: 世界上最高的山峰是珠穆朗玛峰,位于喜马拉雅山脉,海拔8,848.86米。
|
[D]: 世界上最高的山峰是珠穆朗玛峰,位于喜马拉雅山脉,海拔8,848.86米(29,031.69英尺)。
|
||||||
[E]: 世界上最高的山峰是珠穆朗玛峰,位于喜马拉雅山脉,海拔8,848.86米(29,031.69英尺)。
|
[E]: 世界上最高的山峰是珠穆朗玛峰,也称为萨加玛塔,位于喜马拉雅山脉的尼泊尔和中国边境之间,海拔8,848.86米(29,031.69英尺)。它是世界上最著名的登山目标之一,吸引着来自世界各地的登山者前来挑战。珠穆朗玛峰的名字来自藏语,意思是“女神的额峰”,它是由两个不同的山峰组成的,其中一个是位于尼泊尔的珠穆朗玛峰,另一个则位于中国。它的高度是通过测量海拔高度来确定的,因为它是通过测量地球的平均高度来确定的。尽管珠穆朗玛峰是世界上最高的山峰,但它并不是地球上任何其他地方都能到达的。地球上的其他地方,如南美洲的安第斯山脉,也是世界上最高的山脉,但它并不是地球上最高的山峰。总之,珠穆朗玛峰是世界上最高的山峰,但它并不是地球上任何地方都能到达的。它是地球上最高的山脉,但它并不是地球上任何地方都能到达的。
|
||||||
[F]: 世界上最高的山峰是珠穆朗玛峰,也称为萨加玛塔,位于喜马拉雅山脉的尼泊尔和中国边境之间,海拔8,848.86米(29,031.69英尺)。它是世界上最著名的登山目标之一,吸引着来自世界各地的登山者前来挑战。珠穆朗玛峰的名字来自藏语,意思是“女神的额峰”,它是由两个不同的山峰组成的,其中一个是位于尼泊尔的珠穆朗玛峰,另一个则位于中国。它的高度是通过测量海拔高度来确定的,因为它是通过测量地球的平均高度来确定的。尽管珠穆朗玛峰是世界上最高的山峰,但它并不是地球上任何其他地方都能到达的。地球上的其他地方,如南美洲的安第斯山脉,也是世界上最高的山脉,但它并不是地球上最高的山峰。总之,珠穆朗玛峰是世界上最高的山峰,但它并不是地球上任何地方都能到达的。它是地球上最高的山脉,但它并不是地球上任何地方都能到达的。
|
|
||||||
|
|
||||||
|
|
||||||
[Q]: 万有引力是谁提出的?
|
[Q]: 万有引力是谁提出的?
|
||||||
[A]: 万有引力是由英国物理学家牛顿提出的。他认为,所有物体都会产生引力,这个引力是由物体的质量和距离决定的。这个理论揭示了质量和距离之间的关系,并证明了万有引力的本质。
|
[A]: 万有引力是由英国物理学家牛顿提出的。他认为,所有物体都会产生引力,这个引力是由物体的质量和距离决定的。这个理论揭示了质量和距离之间的关系,并证明了万有引力的本质。
|
||||||
[B]: 万有引力是由牛顿发现的,它是由英国物理学家詹姆斯·瓦特于1879年提出的。
|
[B]: 万有引力是由牛顿发现的,它是由英国物理学家詹姆斯·瓦特于1879年提出的。
|
||||||
[C]: 万有引力是谁提出的?
|
[C]: 万有引力是英国物理学家艾萨克·牛顿在17世纪提出的。
|
||||||
[D]: 万有引力是由牛顿提出的,他发现每个物体都会对其他物体施加引力,这些力的大小取决于物体的质量和距离。
|
[D]: 引力是宇宙中一种力量,它是由质量或能量所组成的。根据牛顿的万有引力定律,一个物体之间的引力大小与它的质量成正比,与它的质量成反比。因此,牛顿的万有引力定律表明,一个物体之间的引力大小与它的质量成正比,与它的质量成反比。这个定律在物理学、天文学和物理学中都有广泛的应用。
|
||||||
[E]: 引力是宇宙中一种力量,它是由质量或能量所组成的。根据牛顿的万有引力定律,一个物体之间的引力大小与它的质量成正比,与它的质量成反比。因此,牛顿的万有引力定律表明,一个物体之间的引力大小与它的质量成正比,与它的质量成反比。这个定律在物理学、天文学和物理学中都有广泛的应用。
|
[E]: 万有引力是由英国物理学家艾萨克·牛顿于1687年提出的。他在1687年发表了一篇著名的论文,题为《自然哲学的数学原理》,其中提出了万有引力定律,指出任何两个物体之间都存在着一种引力,这种引力的大小与它们的质量成正比,与它们之间的距离的平方成反比。这个定律被称为万有引力定律,它描述了质量和距离之间的关系。它表明,两个物体之间的引力与它们的质量成正比,与它们之间的距离的平方成反比。这个定律对于解释宇宙中的许多现象和现象之间的相互作用非常重要,例如行星绕太阳运动、恒星之间的引力透镜效应等等。它也被广泛应用于天文学、物理学和工程学等领域,为我们理解宇宙的本质和演化提供了重要的理论基础。
|
||||||
[F]: 万有引力是由英国物理学家艾萨克·牛顿于1687年提出的。他在1687年发表了一篇著名的论文,题为《自然哲学的数学原理》,其中提出了万有引力定律,指出任何两个物体之间都存在着一种引力,这种引力的大小与它们的质量成正比,与它们之间的距离的平方成反比。这个定律被称为万有引力定律,它描述了质量和距离之间的关系。它表明,两个物体之间的引力与它们的质量成正比,与它们之间的距离的平方成反比。这个定律对于解释宇宙中的许多现象和现象之间的相互作用非常重要,例如行星绕太阳运动、恒星之间的引力透镜效应等等。它也被广泛应用于天文学、物理学和工程学等领域,为我们理解宇宙的本质和演化提供了重要的理论基础。
|
|
||||||
|
|
||||||
|
|
||||||
[Q]: 你知道大熊猫的主要食物是什么吗?
|
[Q]: 你知道大熊猫的主要食物是什么吗?
|
||||||
[A]: 大熊猫的主要食物是竹子。它们通常吃竹子,每天需要吃掉大约30公斤的竹子。
|
[A]: 大熊猫的主要食物是竹子。它们通常吃竹子,每天需要吃掉大约30公斤的竹子。
|
||||||
[B]: 大熊猫主要是竹子,它们的主要食物是竹子。大熊猫的消化系统比较特殊,它们每天需要消化大量的竹子才能维持其生存需要。除了竹子外,大熊猫还在野外生存。
|
[B]: 大熊猫主要是竹子,它们的主要食物是竹子。大熊猫的消化系统比较特殊,它们每天需要消化大量的竹子才能维持其生存需要。除了竹子外,大熊猫还在野外生存。
|
||||||
[C]: 大熊猫的主要食物是竹子、蘑菇、蘑菇、甜菜和蘑菇。
|
[C]: 大熊猫主要以竹子为食,也会偶尔食用其他的植物和动物。此外,大熊猫也会吃一些野果、小动物和植物,但这些都不属于它们的主要食物来源。
|
||||||
[D]: 大熊猫是一种以竹子为食的哺乳动物,但主要食物来源是竹笋、竹叶、茎、茎等。
|
[D]: 大熊猫的主要食物是竹子。
|
||||||
[E]: 大熊猫的主要食物是竹子。
|
[E]: 大熊猫是一种以竹子为主要食物的植食动物,它们的肠道结构适合消化纤维素含量高的竹子,但也会吃一些其他植物,如草本植物和小型哺乳动物。大熊猫的肠道结构也适应了高纤维的竹子,这使得它们能够消化大量的纤维素,从而帮助它们在野外生存。大熊猫的肠道中还含有一种叫做“纤维素酶”的酶类物质,这种酶能够帮助大熊猫分解纤维素,从而帮助它们消化大量的水分和营养物质。此外,大熊猫的肠道还含有一种叫做“纤维素蛋白”的蛋白质,这种蛋白质能够帮助大熊猫维持体内的能量水平,从而帮助它们在野外生存。总的来说,大熊猫的主要食物是竹子,但它们也会吃一些其他植物,如草本植物和小型哺乳动物。
|
||||||
[F]: 大熊猫是一种以竹子为主要食物的植食动物,它们的肠道结构适合消化纤维素含量高的竹子,但也会吃一些其他植物,如草本植物和小型哺乳动物。大熊猫的肠道结构也适应了高纤维的竹子,这使得它们能够消化大量的纤维素,从而帮助它们在野外生存。大熊猫的肠道中还含有一种叫做“纤维素酶”的酶类物质,这种酶能够帮助大熊猫分解纤维素,从而帮助它们消化大量的水分和营养物质。此外,大熊猫的肠道还含有一种叫做“纤维素蛋白”的蛋白质,这种蛋白质能够帮助大熊猫维持体内的能量水平,从而帮助它们在野外生存。总的来说,大熊猫的主要食物是竹子,但它们也会吃一些其他植物,如草本植物和小型哺乳动物。
|
|
||||||
|
|
||||||
[Q]: 海水为什么是咸的?
|
[Q]: 海水为什么是咸的?
|
||||||
[A]: 海水中含有许多盐分,这些盐分可以导致海水咸度的增加。海水中的盐分主要来自于海水中的盐分,这些盐分可以从海水中的盐分中获得。海水中的氧化物和盐分可以与海水中的盐分形成氢键,从而使海水咸度增加。
|
[A]: 海水中含有许多盐分,这些盐分可以导致海水咸度的增加。海水中的盐分主要来自于海水中的盐分,这些盐分可以从海水中的盐分中获得。海水中的氧化物和盐分可以与海水中的盐分形成氢键,从而使海水咸度增加。
|
||||||
[B]: 海水中含有丰富的钙、磷、钾和磷等元素,这些元素在海洋中的数量和分布非常有限。此外,海水中还含有各种生物和微生物的营养物质,如贝壳和海藻等。
|
[B]: 海水中含有丰富的钙、磷、钾和磷等元素,这些元素在海洋中的数量和分布非常有限。此外,海水中还含有各种生物和微生物的营养物质,如贝壳和海藻等。
|
||||||
[C]: 咸的是海水,因为海水的溶解度高于海水。海水的碳酸盐和盐基度也高于海水,这是因为海水的碳酸盐和盐基度都非常高,海水的碳酸盐和盐基度也非常高。
|
[C]: 海水含有许多溶解的盐类,其中最主要的是氯化钠。当水中加入盐时,盐的分子会与水分子发生反应,形成氢氧化钠,这是一种盐。
|
||||||
[D]: 海水中含有溶解盐类和其他矿物质,这些物质来自于地壳的侵蚀和吸附作用,而这些物质会溶解在水中,导致海水呈现咸味。
|
[D]: 因为水是许多生物的生存所必需的,它能够吸收和释放二氧化碳,释放氧气,维持大气中的水蒸气,以及维持水循环。水中的盐类和化学物质会释放出氧气,使地球上的生物呼吸。此外,水还具有许多其他功能,如保持水循环、维持水循环、调节气候和环境等。水是许多生物生存所必需的,它也是许多自然现象的重要基础。
|
||||||
[E]: 因为水是许多生物的生存所必需的,它能够吸收和释放二氧化碳,释放氧气,维持大气中的水蒸气,以及维持水循环。水中的盐类和化学物质会释放出氧气,使地球上的生物呼吸。此外,水还具有许多其他功能,如保持水循环、维持水循环、调节气候和环境等。水是许多生物生存所必需的,它也是许多自然现象的重要基础。
|
[E]: 海水是咸的主要原因是因为其中含有大量的溶解盐类,其中最主要的是氯化钠(NaCl)。氯化钠是一种非常常见的盐类,它存在于地球上的大部分地区,包括海洋、湖泊、河流和地下水。当水从海洋中蒸发时,它会带走一部分盐分,使海水变得咸。此外,海中还含有其他溶解盐类的物质,如硫酸盐、硫酸镁、硫酸钙、硫酸镁盐、硫酸镁钾、硫酸镁钠、硫酸镁钙、硫酸镁镁钙、硫酸镁镁钙、硫酸镁镁钙、硫酸镁镁钠、硫酸镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁镁钙、硫酸镁镁镁镁镁镁钙、硫酸镁镁镁镁镁镁钙、硫酸镁镁镁镁镁镁镁钙、硫酸镁镁镁镁
|
||||||
[F]: 海水是咸的主要原因是因为其中含有大量的溶解盐类,其中最主要的是氯化钠(NaCl)。氯化钠是一种非常常见的盐类,它存在于地球上的大部分地区,包括海洋、湖泊、河流和地下水。当水从海洋中蒸发时,它会带走一部分盐分,使海水变得咸。此外,海中还含有其他溶解盐类的物质,如硫酸盐、硫酸镁、硫酸钙、硫酸镁盐、硫酸镁钾、硫酸镁钠、硫酸镁钙、硫酸镁镁钙、硫酸镁镁钙、硫酸镁镁钙、硫酸镁镁钠、硫酸镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁钙、硫酸镁镁镁镁镁镁钙、硫酸镁镁镁镁镁镁钙、硫酸镁镁镁镁镁镁钙、硫酸镁镁镁镁镁镁镁钙、硫酸镁镁镁镁
|
|
||||||
```
|
```
|
||||||
|
|
||||||
> [!NOTE]
|
> [!NOTE]
|
||||||
|
|
@ -475,78 +485,54 @@ MobileLLM提出架构的深度比宽度更重要,「深而窄」的「瘦长
|
||||||
|
|
||||||
---
|
---
|
||||||
|
|
||||||
### 模型评分和表现总结:
|
### 模型表现点评:
|
||||||
|
|
||||||
**A模型**
|
1. **模型A**:
|
||||||
|
- **表现**:模型A的回答通常简洁明了,但在某些问题上缺乏详细信息和准确性。例如,在长江的长度问题上,模型A的回答是错误的。
|
||||||
|
- **评分**:60
|
||||||
|
|
||||||
- **准确性**:大部分回答准确,但偶尔会有轻微错误。
|
2. **模型B**:
|
||||||
**清晰性**:回答简洁明了,语言流畅。
|
- **表现**:模型B的回答在某些问题上提供了额外的信息,但这些信息有时是不准确的或多余的。例如,在长江的长度问题上,模型B提供了不准确的长度和流域面积。
|
||||||
**完整性**:回答内容有时略显简单,但整体信息足够。
|
- **评分**:65
|
||||||
**评分**:80分
|
|
||||||
|
|
||||||
**B模型**
|
3. **模型C**:
|
||||||
|
- **表现**:模型C的回答通常较为详细,且在大多数问题上提供了准确的信息。例如,在长江和泰山的问题上,模型C的回答是准确的。
|
||||||
|
- **评分**:75
|
||||||
|
|
||||||
- **准确性**:多数回答准确,但有部分小错误(如第一颗人造卫星的问题)。
|
4. **模型D**:
|
||||||
**清晰性**:语言较为清晰,但有时表达稍显混乱。
|
- **表现**:模型D的回答在某些问题上显得混乱,且缺乏准确性。例如,在泰山的问题上,模型D的回答完全偏离了主题。
|
||||||
**完整性**:回答内容较全面,但存在信息误差。
|
- **评分**:50
|
||||||
**评分**:75分
|
|
||||||
|
|
||||||
**C模型**
|
5. **模型E**:
|
||||||
|
- **表现**:模型E的回答通常非常详细,但在某些问题上过于冗长,且包含了一些不必要的信息。例如,在万有引力的问题上,模型E的回答过于复杂。
|
||||||
|
- **评分**:70
|
||||||
|
|
||||||
- **准确性**:回答内容不准确,且多次出现自问自答的情况。
|
#### 排序(从高到低):
|
||||||
**清晰性**:语言流畅,但回答内容的逻辑性差。
|
|
||||||
**完整性**:信息不完整,有时缺乏重要细节。
|
|
||||||
**评分**:55分
|
|
||||||
|
|
||||||
**D模型**
|
| 模型 | C | E | B | A | D |
|
||||||
|
|----|----|----|----|----|----|
|
||||||
- **准确性**:大多数回答准确,基本符合事实。
|
| 分数 | 75 | 70 | 65 | 60 | 50 |
|
||||||
**清晰性**:表达清晰,信息量适中。
|
|
||||||
**完整性**:回答较为完整,但有些答案可能包含不必要的细节。
|
|
||||||
**评分**:85分
|
|
||||||
|
|
||||||
**E模型**
|
|
||||||
|
|
||||||
- **准确性**:准确度较低,部分回答甚至与问题无关。
|
|
||||||
**清晰性**:表达不够清晰,容易引起混淆。
|
|
||||||
**完整性**:信息不完整,且有时偏离主题。
|
|
||||||
**评分**:50分
|
|
||||||
|
|
||||||
**F模型**
|
|
||||||
|
|
||||||
- **准确性**:部分回答不准确,且有明显错误(如“24天”)。
|
|
||||||
**清晰性**:表达冗长,容易造成混淆。
|
|
||||||
**完整性**:信息过度冗长,且有重复内容,降低了答案的可读性。
|
|
||||||
**评分**:60分
|
|
||||||
|
|
||||||
### 排序(从高到低):
|
|
||||||
|
|
||||||
| 模型 | D模型 | A模型 | B模型 | F模型 | C模型 | E模型 |
|
|
||||||
|----|-----|-----|-----|-----|-----|-----|
|
|
||||||
| 分数 | 85 | 80 | 75 | 60 | 55 | 50 |
|
|
||||||
|
|
||||||
这些评分和排序基于每个模型在准确性、清晰性和完整性三个方面的综合表现。
|
|
||||||
|
|
||||||
---
|
---
|
||||||
|
|
||||||
## 👉效果总结
|
## 👉效果总结
|
||||||
|
|
||||||
* minimind系列(ABCD)的排序符合直觉,minimind(0.2B)评分最高,常识性问题的回答基本没有错误和幻觉。
|
* minimind系列(ABC)的排序符合直觉,minimind-v1(0.1B)评分最高,常识性问题的回答基本没有错误和幻觉。
|
||||||
* 出乎意料的是,minimind-small-T(0.02B)仅有26M参数,却可以接近minimind(0.2B)的表现。
|
* 出乎意料的是,minimind-v1-small(0.02B)仅有26M参数,却可以接近minimind-v1(0.1B)的表现。
|
||||||
* minimind(0.2B)的sft轮数`epochs`仅有不到2,因为训练时间是0.02B的好几倍,所以偷懒提前kill腾出资源给小模型,0.2B没有得到充分训练的情况下依然做到了最强,其实还是底大一级压死人。
|
* minimind-v1(0.1B)的sft轮数`epochs`仅有不到2,偷懒提前kill腾出资源给小模型,0.1B没有得到充分训练的情况下依然做到了最强,其实还是底大一级压死人。
|
||||||
* minimind-MoE(0.16B)表现很差,甚至不如它同配置的dense模型minimind(0.05B)
|
* minimind-v1-moe(0.1B)
|
||||||
,其实这并非MoE的锅。同样是因为偷懒提前kill腾出资源给小模型,但是MoE模型多专家模式需要的训练轮次本来就需要酌情更高,在epochs设置为2时训练的极其不充分。minimind不久前实验阶段在Yi
|
表现很差,同样是因为偷懒提前kill腾出资源给小模型,但是MoE模型多专家模式需要的训练轮次本来就需要酌情更高,在epochs设置为2时训练的极其不充分。minimind不久前实验阶段在Yi
|
||||||
tokenizer上试验过MoE的充分训练版本,可以做到比dense表现肉眼可见的好。现在先这样了hh,日后腾出服务器再训练更新v2 v3版本。
|
tokenizer上试验过moe的充分训练版本,可以做到比dense表现肉眼可见的更好。日后腾出服务器再训练更新v2、v3版本。
|
||||||
|
|
||||||
|
|
||||||
* F模型的回答看起来是这里最完美的,尽管存在些许幻觉瞎编的情况。但GPT-4o和kimi的评分都一致认为它“信息过度冗长,且有重复内容,存在幻觉”。
|
* E模型的回答看起来是这里最完美的,尽管存在些许幻觉瞎编的情况。但GPT-4o和Deepseek的评分都一致认为它“信息过度冗长,且有重复内容,存在幻觉”。
|
||||||
其实这种评价太严格了,100个字中有10个字是幻觉,就很容易把它归到0分。由于F模型训练文本默认长度更长,数据集大得多,所以回答的看起来很完备,在体积近似的情况下,数据比模型更重要得多。
|
其实这种评价太严格了,100个字中有10个字是幻觉,就很容易把它归到0分。由于F模型训练文本默认长度更长,数据集大得多,所以回答的看起来很完备,在体积近似的情况下,数据比模型更重要得多。
|
||||||
|
|
||||||
> 🙋♂️个人主观评价:F>D>A≈B>C>E
|
> 🙋♂️个人主观评价:E>C>B≈A>D
|
||||||
|
|
||||||
> 🤖GPT-4o评价:D>A>B>F>C>E
|
> 🤖 GPT-4o 评价:C>E>B>A>D
|
||||||
|
|
||||||
总而言之scaling law:模型参数越大,训练数据越多模型的性能越强。
|
Scaling Law:模型参数越大,训练数据越多模型的性能越强。
|
||||||
|
|
||||||
# 📌 Objective dataset: C-Eval
|
# 📌 Objective dataset: C-Eval
|
||||||
|
|
||||||
|
|
@ -577,11 +563,9 @@ minimind模型本身没有使用较大的数据集训练,也没有针对回答
|
||||||
#### 结果汇总:
|
#### 结果汇总:
|
||||||
|
|
||||||
| category | correct | question_count | accuracy |
|
| category | correct | question_count | accuracy |
|
||||||
|:-----------------|:--------:|:--------------:|:---------:|
|
|:------------------|:--------:|:--------------:|:--------:|
|
||||||
| minimind-small-T | 344 | 1346 | 25.56% |
|
| minimind-v1-small | 344 | 1346 | 25.56% |
|
||||||
| minimind-small | 312 | 1346 | 23.18% |
|
| minimind-v1 | 351 | 1346 | 26.08% |
|
||||||
| minimind | 351 | 1346 | 26.08% |
|
|
||||||
| minimind-moe | 316 | 1346 | 23.48% |
|
|
||||||
|
|
||||||
#### 以下来自GPT-4o对minimind表现的瞎猜:
|
#### 以下来自GPT-4o对minimind表现的瞎猜:
|
||||||
|
|
||||||
|
|
@ -672,24 +656,50 @@ minimind模型本身没有使用较大的数据集训练,也没有针对回答
|
||||||
> 如果您觉得 `MiniMind`对您有所帮助,请在 GitHub 上给一个⭐<br/>
|
> 如果您觉得 `MiniMind`对您有所帮助,请在 GitHub 上给一个⭐<br/>
|
||||||
> 您的支持是我们持续改进项目的动力!篇幅不短水平有限难免纰漏,欢迎在issue交流和指正。
|
> 您的支持是我们持续改进项目的动力!篇幅不短水平有限难免纰漏,欢迎在issue交流和指正。
|
||||||
|
|
||||||
## 🤝贡献者
|
## 🤝[贡献者](https://github.com/jingyaogong/minimind/graphs/contributors)
|
||||||
|
|
||||||
<br/>
|
|
||||||
|
|
||||||
|
<!--
|
||||||
<a href="https://github.com/jingyaogong/minimind/graphs/contributors">
|
<a href="https://github.com/jingyaogong/minimind/graphs/contributors">
|
||||||
<img src="https://contrib.rocks/image?repo=jingyaogong/minimind&v=2" />
|
<img src="https://contrib.rocks/image?repo=jingyaogong/minimind&v3" />
|
||||||
|
</a>
|
||||||
|
-->
|
||||||
|
|
||||||
|
<a href="https://github.com/jingyaogong"><img src="https://avatars.githubusercontent.com/u/62287848" width="70px" height="70px"/></a>
|
||||||
|
|
||||||
|
<a href="https://github.com/MuWinds"><img src="https://avatars.githubusercontent.com/u/93832089" width="70px" height="70px"/></a>
|
||||||
|
|
||||||
|
<a href="https://github.com/chuanzhubin"><img src="https://avatars.githubusercontent.com/u/2813798" width="70px" height="70px"/></a>
|
||||||
|
|
||||||
|
|
||||||
|
## 😊鸣谢
|
||||||
|
|
||||||
|
<a href="https://github.com/ipfgao"><b>@ipfgao</b></a>:
|
||||||
|
<a href="https://github.com/jingyaogong/minimind/issues/26">🔗训练步骤记录</a>
|
||||||
|
|
||||||
|
## 🫶支持者
|
||||||
|
|
||||||
|
<a href="https://github.com/jingyaogong/minimind/stargazers">
|
||||||
|
<picture>
|
||||||
|
<source media="(prefers-color-scheme: dark)" srcset="https://reporoster.com/stars/dark/jingyaogong/minimind"/>
|
||||||
|
<source media="(prefers-color-scheme: light)" srcset="https://reporoster.com/stars/jingyaogong/minimind"/>
|
||||||
|
<img alt="github contribution grid snake animation" src="https://reporoster.com/stars/jingyaogong/minimind"/>
|
||||||
|
</picture>
|
||||||
</a>
|
</a>
|
||||||
|
|
||||||
## 🫶感谢支持!
|
<a href="https://github.com/jingyaogong/minimind/network/members">
|
||||||
|
<picture>
|
||||||
|
<source media="(prefers-color-scheme: dark)" srcset="https://reporoster.com/forks/dark/jingyaogong/minimind"/>
|
||||||
|
<source media="(prefers-color-scheme: light)" srcset="https://reporoster.com/forks/jingyaogong/minimind"/>
|
||||||
|
<img alt="github contribution grid snake animation" src="https://reporoster.com/forks/jingyaogong/minimind"/>
|
||||||
|
</picture>
|
||||||
|
</a>
|
||||||
|
|
||||||
[](https://github.com/jingyaogong/minimind/stargazers)
|
<picture>
|
||||||
|
<source media="(prefers-color-scheme: dark)" srcset="https://api.star-history.com/svg?repos=jingyaogong/minimind&type=Date&theme=dark"/>
|
||||||
[](https://github.com/jingyaogong/minimind/network/members)
|
<source media="(prefers-color-scheme: light)" srcset="https://api.star-history.com/svg?repos=jingyaogong/minimind&type=Date"/>
|
||||||
|
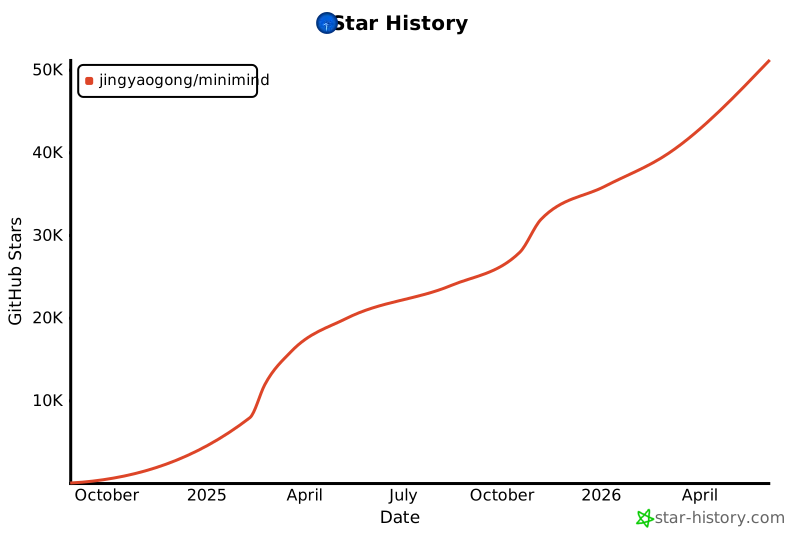
<img alt="Star History Chart" src="https://api.star-history.com/svg?repos=jingyaogong/minimind&type=Date"/>
|
||||||
|
</picture>
|
||||||
|
|
||||||
# License
|
# License
|
||||||
|
|
||||||
This repository is licensed under the [Apache-2.0 License](LICENSE).
|
This repository is licensed under the [Apache-2.0 License](LICENSE).
|
||||||
|
|
||||||
|
|
||||||
|
|
|
||||||
Loading…
Reference in New Issue